 Guilherme Emanuel
IA local — executar modelos de linguagem offline em um notebook com 8 GB de RAM é viável, mas muda a experiência: os arquivos dos modelos podem ter entre 523 MB e 2,5 GB e a geração de respostas tende a ser mais lenta sem GPU. Para quem precisa de privacidade ou trabalho offline, a solução exige escolha cuidadosa do modelo, versões quantizadas e ajustes de contexto.
Modelos compactos que cabem em 8 GB e o que esperar
Modelos indicados para começar variam de ~600 milhões a 3 bilhões de parâmetros e ocupam downloads que vão de cerca de 523 MB a 2,5 GB. Exemplos práticos incluem Qwen3 0.6B (≈523 MB), Gemma 3 1B (≈806 MB), Qwen2.5 Coder 1.5B (≈986 MB), Llama 3.2 1B (≈1,3 GB) e Qwen3 1.7B (≈1,4 GB).
 Pix: comprovante falso — confirme no extrato antes de liberar
Leia a matéria completa →
 iPhone 15: 128 GB sai por 12x de R$ 304,98 com cupom
Leia a matéria completa →
 Sílvia Cunha Lima terá nova eleição após cassação mantida pelo TRE-PB
Leia a matéria completa →
 Tabela do Brasileirão 2026: classificação atualizadaVer classificação, artilharia e próximos jogos →
A falta de GPU não impede a execução: ferramentas como Ollama, Jan e GPT4All permitem rodar modelos na CPU, mas a velocidade depende do processador, do histórico de conversa e do uso de RAM por outros programas.
Modelos compactos como Qwen3 0.6B e Gemma 3 1B ocupam entre 523 MB e 806 MB no download e são indicações práticas para testar IA local em notebooks com 8 GB de RAM.
Como instalar e otimizar um assistente local no Windows
Uma configuração prática usa Ollama e o Qwen3 1.7B: baixe o instalador do aplicativo, abra o Terminal ou PowerShell e execute o comando ollama run qwen3:1.7b — o modelo (~1,4 GB) será baixado e, depois, você conversa com ele localmente.
Para reduzir consumo de memória, prefira variantes quantizadas (ex.: Q4_K_M), limite o contexto com /set parameter num_ctx 2048, feche navegadores e apps pesados e, se possível, use SSD para acelerar carregamento. Descarregue o modelo com ollama stop qwen3:1.7b quando não estiver em uso.
O que você acha? Você já tentou rodar IA local em um notebook mais modesto ou conhece alguém que fez isso? Para acompanhar mais, acesse nossa editoria.
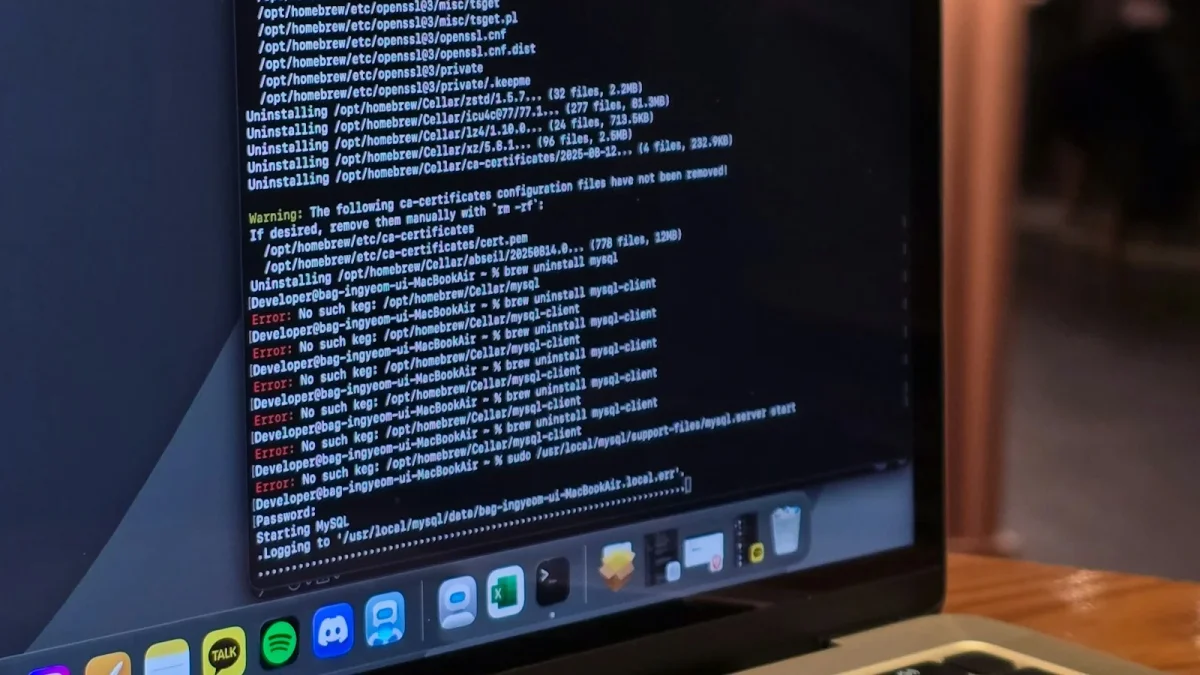 Foto: Divulgação
Imagem: Divulgação
Perguntas Frequentes
Quais modelos de IA local rodam em um PC com 8 GB de RAM sem placa de vídeo?
IA local pode rodar com modelos pequenos; entre opções práticas estão Qwen3 0.6B (≈523 MB), Gemma 3 1B (≈806 MB), Qwen2.5 Coder 1.5B (≈986 MB) e Qwen3 1.7B (≈1,4 GB). Modelos quantizados e versões de 0.6–3B parâmetros costumam ser as escolhas mais seguras para CPUs sem GPU.
Como instalar e executar o Qwen3 1.7B no Windows usando Ollama em um PC com 8 GB?
O Qwen3 1.7B pode ser instalado com Ollama: instale o aplicativo no Windows, abra Terminal/PowerShell e rode ollama run qwen3:1.7b; o download do modelo (~1,4 GB) exige internet. Após o download, a conversa ocorre localmente e a execução ficará a cargo da CPU, exigindo paciência em processadores mais antigos.
Quais ajustes reduzem o uso de memória em IA local sem GPU em notebooks com 8 GB?
Para IA local sem GPU, reduza o contexto (por exemplo /set parameter num_ctx 2048), escolha versões quantizadas como Q4_K_M, feche navegadores e apps pesados e evite manter múltiplos modelos carregados. Usar modelos menores (Gemma 3 1B ou Qwen3 0.6B) ajuda a manter a experiência funcional em 8 GB.