 Thiago Nogueira
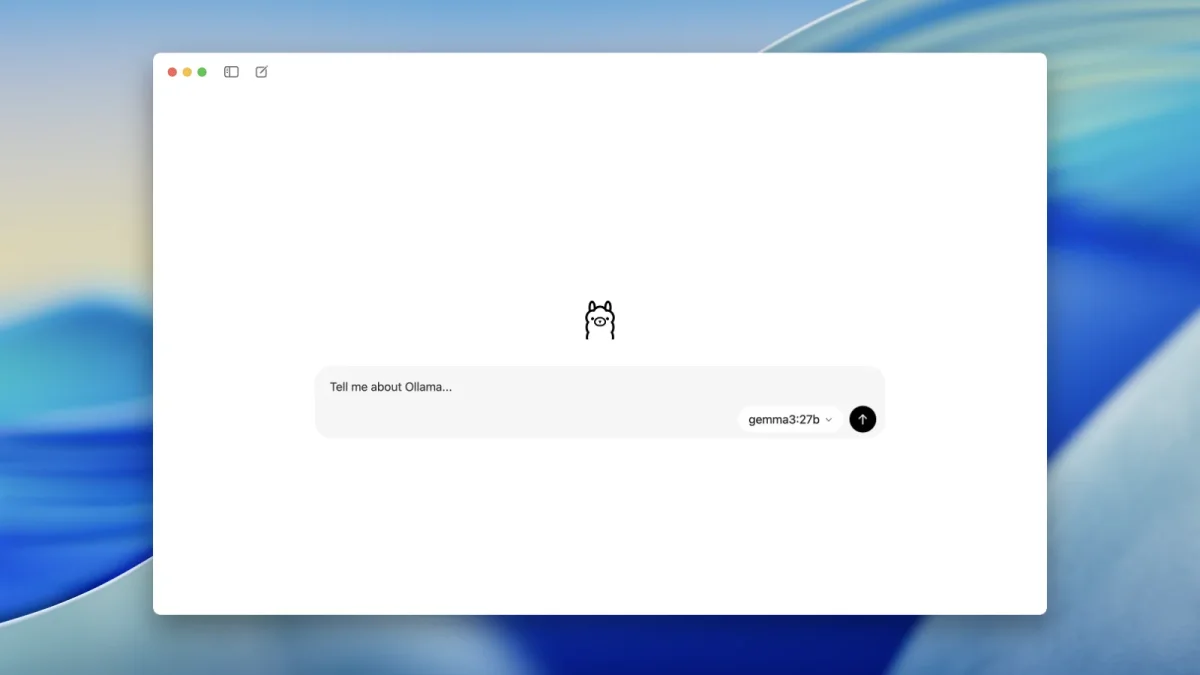
Ollama — instalar e testar uma IA no próprio PC ficou muito mais simples: o aplicativo roda nativamente no Windows, baixa modelos como Gemma 3 1B e libera uma conversa local sem exigir Docker, WSL ou cadastro em provedores de nuvem. Isso reduz a barreira técnica para quem quer experimentar LLMs sem depender de serviços remotos.
Instalação prática e primeiro teste pelo PowerShell
O instalador padrão do Ollama para Windows dispensa privilégios de administrador em muitos casos e requer pelo menos 4 GB de espaço para o app, além do espaço para os modelos. A instalação nativa é compatível com Windows 10 versão 22H2 ou posterior e com Windows 11.
 Pix: comprovante falso — confirme no extrato antes de liberar
Leia a matéria completa →
 iPhone 15: 128 GB sai por 12x de R$ 304,98 com cupom
Leia a matéria completa →
 Sílvia Cunha Lima terá nova eleição após cassação mantida pelo TRE-PB
Leia a matéria completa →
 Tabela do Brasileirão 2026: classificação atualizadaVer classificação, artilharia e próximos jogos →
Para testar rapidamente, abra o PowerShell e execute ollama run gemma3:1b. Na primeira vez o comando baixa a variante Gemma 3 1B — aproximadamente 806 MB — e, ao concluir, entra no modo de conversa local, indicado pelo prompt do terminal.
Após o download, modelos como Gemma 3 1B podem funcionar offline: a IA responde sem enviar prompts para servidores externos, desde que a variante escolhida seja local.
Requisitos, modelos e privacidade de uso
Não é obrigatória uma GPU dedicada: o Ollama executa modelos menores apenas na CPU, embora GPUs NVIDIA, AMD ou Intel compatíveis acelerarem respostas e permitirem variantes maiores. Memória RAM é o fator-chave; 8 GB suportam modelos de 1B em uso básico, enquanto 16 GB ou mais ampliam as opções.
O app mantém uma API local normalmente em http://localhost:11434, útil para integrar a IA a scripts e aplicações próprias. Modelos marcados como :cloud exigem conexão e, possivelmente, conta — para um teste totalmente local, escolha explicitamente variantes como gemma3:1b ou llama3.2:1b.
O que você acha? Você já testou IA local no seu PC e qual foi a experiência? Para ver mais conteúdos relacionados, acesse nossa editoria.
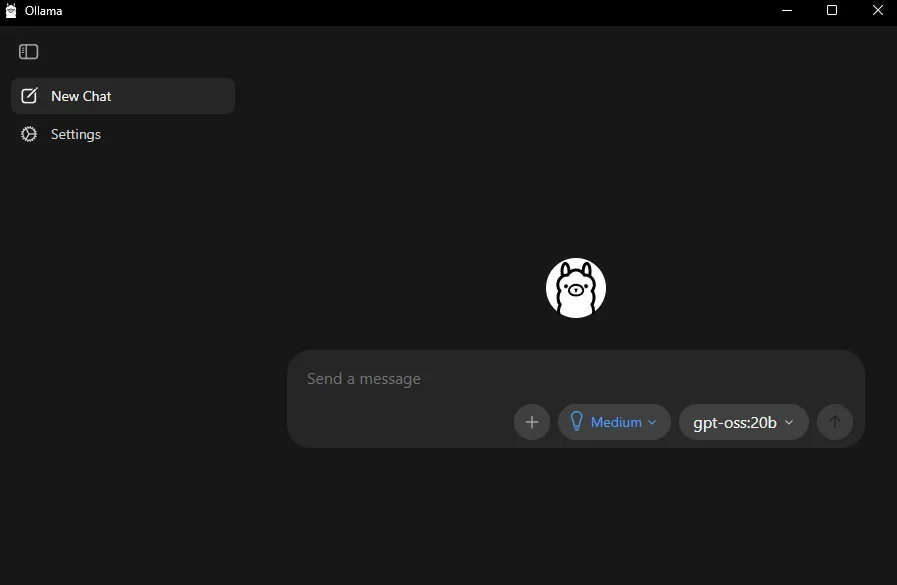 Foto: Divulgação
Imagem: Divulgação
Perguntas Frequentes
Como instalar e verificar se o Ollama funcionou no Windows?
O Ollama pode ser instalado via instalador gráfico para Windows; depois abra o PowerShell e execute ollama --version para confirmar a instalação. Se o comando retornar um número de versão, o binário está no PATH; em falhas, reiniciar o sistema ou reinstalar costuma corrigir a inclusão no PATH.
Qual comando inicia a primeira IA local e quanto pesa o modelo Gemma 3 1B?
O comando recomendado é ollama run gemma3:1b, que baixa e inicia o modelo Gemma 3 1B; o arquivo tem aproximadamente 806 MB. Depois do download, o modelo permanece no disco até ser removido com ollama rm, permitindo conversas offline sem nova transferência.
Preciso de GPU para usar o Ollama no Windows e como checar se ela está sendo usada?
Não é obrigatório ter GPU: modelos de 1B podem rodar só na CPU, embora GPUs compatíveis acelerem o processo. Durante uma conversa, execute ollama ps para ver a coluna PROCESSOR, que indica uso como 100% GPU, 100% CPU ou uma distribuição entre ambos.